W tym tekście: 6 części
Robots.txt jest plikiem o dostępie, a nie o prawach do treści. Tę granicę wyznaczyli Gary Illyes i Cherry Prommawin z Google Search Relations w drugim odcinku serii The Non-Canonical Cabinet, opublikowanym 21 października 2026. Odcinek ma formę komediowego skeczu z kurczakiem w tle, ale wnioski są poważne. Reguła disallow mówi botowi, czy może wejść na stronę, a nie co zrobi z treścią, którą już pobrał.
Dla zespołów SEO i właścicieli serwisów oznacza to konieczność rozdzielenia dwóch pytań: kto może pobierać treści i do czego wolno je potem wykorzystać.
Co powiedzieli gospodarze
Zgodnie z relacją PPC Land gospodarze opisali robots.txt jako prosty plik tekstowy w katalogu głównym witryny, zdefiniowany w standardzie RFC 9309. Bot, który przestrzega zasad, sprawdza ten plik, zanim zacznie czytać treść. Kluczowe jest słowo „przestrzega”: zgodność jest dobrowolna. Sam standard stwierdza, że reguły nie są formą autoryzacji dostępu.
Trzeba pamiętać, że to prezentacja Google'a, a nie niezależne badanie. Transkrypcja pochodzi z automatycznych napisów YouTube, więc część cytatów jest zniekształcona.
Cztery pola i ciche odrzucanie reszty
Parser Google'a rozumie user-agent, allow, disallow i sitemap. Wszystko inne jest po cichu pomijane. Gospodarze podali przykład reguły napisanej zwykłym językiem: taki zapis nie jest poprawną regułą, więc robot go zignoruje i może odwiedzić stronę, którą autor chciał ukryć. Nie zadziałają też własne reguły, które mają zakazać użycia treści do trenowania modeli.
Dokumentacja Google'a potwierdza kilka szczegółów istotnych w praktyce:
- plik musi być zapisany w UTF-8, a Google egzekwuje limit 500 KiB i ignoruje treść po jego przekroczeniu,
- nieobsługiwane pola, takie jak crawl-delay, nie działają,
- ścieżki z surowymi znakami UTF-8 Google zamienia na zapis procentowy, więc reguły dla polskich znaków w adresach zadziałają w jego parserze.
Odcinek zaleca jednak zapis zakodowany, bo inne lub starsze boty mogą się w takich znakach pogubić. To zalecenie gospodarzy; nie podali oni, które boty mają ten problem. Tokeny user-agent nie mogą natomiast zawierać emoji ani znaków spoza ASCII.
Dostęp kontra użycie: gdzie jest Google-Extended
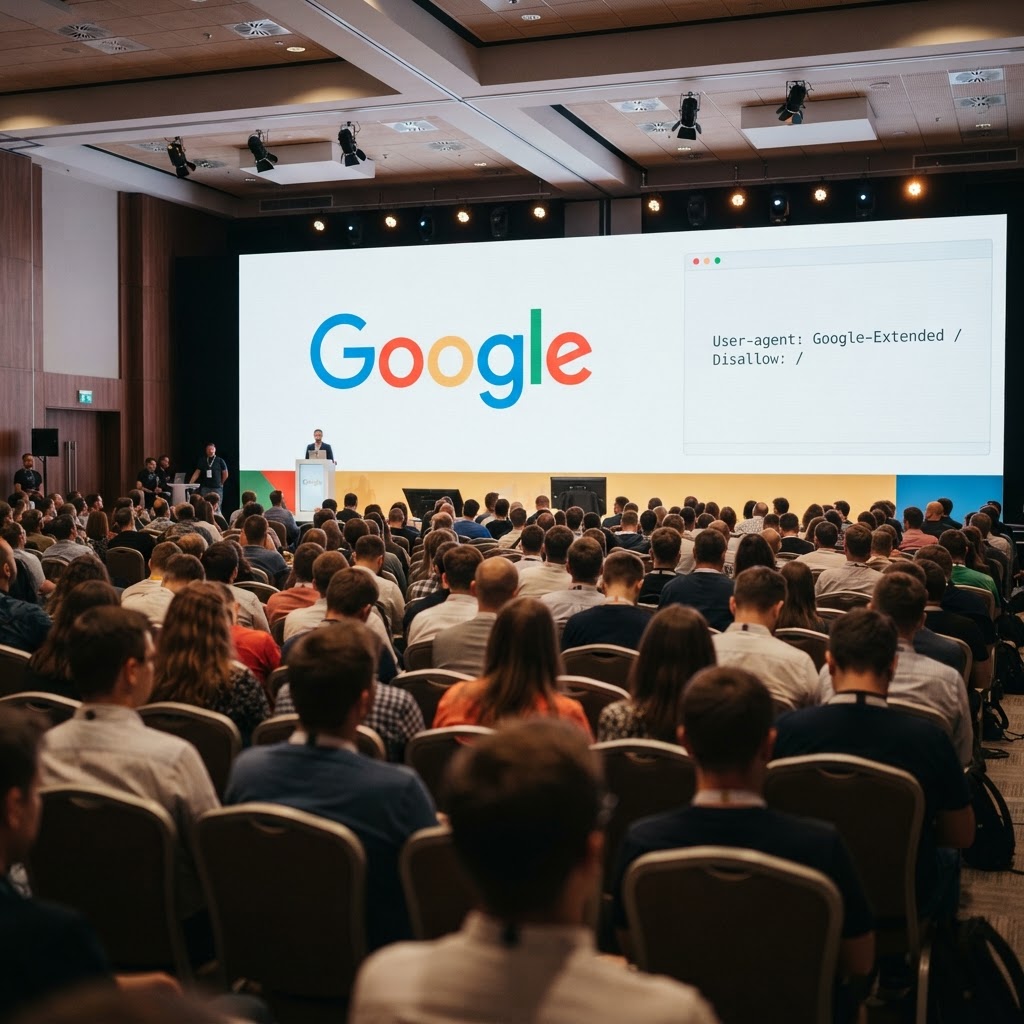
Najważniejsze zdanie odcinka brzmi w skrócie tak: robots.txt to protokół preferencji dostępu i nie dyktuje, co system robi z danymi po pobraniu. Żeby zatrzymać konkretnego bota AI, trzeba jawnie wskazać jego token.
Tu pojawia się napięcie, którego odcinek nie poruszył. Google-Extended jest tokenem w robots.txt, który nie ma własnego crawlera. Według opisu PPC Land token pozwala stronie określić, czy treści zbierane przez roboty Google'a mogą trenować modele Gemini i służyć do osadzania odpowiedzi (grounding) w Gemini Apps i Vertex AI.
Jedna reguła obejmuje oba zastosowania, więc rezygnacja z treningu oznacza też rezygnację z cytowań w Gemini. Token nie obejmuje AI Overviews ani AI Mode. Formalnie to zwykła grupa user-agent, ale w praktyce niesie preferencję dotyczącą użycia danych, a nie tylko dostępu.
Jest też konsekwencja operacyjna: skoro żadne żądanie nie przychodzi pod nazwą Google-Extended, w logach serwera nie sprawdzisz, czy dyrektywa jest respektowana. Pozostaje zaufanie do deklaracji Google'a.
Dane: ile botów omija blokady
Odcinek o tym nie mówił, ale kontekst dobrze pokazuje granice modelu opartego na dobrowolności. PPC Land przytacza dwa zestawy danych:
- TollBit (firma analizująca ruch botów AI) wskazał w danych za pierwsze półrocze 2026, że około 15% zidentyfikowanych agentów AI pobierających strony dotarło do adresów, które europejskie serwisy zablokowały,
- test HasData z lipca: spośród 592 serwisów blokujących GPTBot 234 nadal wydawało mu aktywną stronę.
Oba wyniki znamy z relacji PPC Land. W teście HasData żądania podszywały się pod GPTBot, a nie pochodziły ze zweryfikowanego crawlera OpenAI, więc odpowiedź 200 mogła wynikać z innych czynników. Dane należy traktować jako sygnał, a nie twardą miarę skali zjawiska.
Co to oznacza dla marketerów w Polsce
Zrób audyt pliku. Sprawdź, czy w robots.txt nie ma reguł napisanych po ludzku, wpisów z crawl-delay i szablonów skopiowanych z 2023 roku. Każda taka linia daje złudne poczucie kontroli.
Podejmij decyzję o Google-Extended świadomie. Domyślnie treści są dostępne. Blokada wyłącza trening i grounding w Gemini, ale kosztuje potencjalne cytowania w tych produktach i nie wpływa na AI Overviews ani AI Mode. Dla wydawców z treściami płatnymi i dla marek, którym zależy na obecności w odpowiedziach AI, rachunek będzie inny. Powiązane tło znajdziesz w naszym przewodniku o GEO.
Nie używaj robots.txt jako zabezpieczenia. Plik jest publiczny, a zablokowana strona nadal może pojawić się w wynikach, jeśli ktoś na nią linkuje. Treści poufne chroń logowaniem, a nie dyrektywą.
Zapisuj ścieżki ze znakami spoza ASCII w formie zakodowanej. To drobna zmiana, która ogranicza ryzyko, że starszy bot źle zinterpretuje regułę z polskimi znakami.
Nie opieraj ochrony wyłącznie na pliku. Jeśli ruch botów ma znaczenie biznesowe, potrzebne są warstwy po stronie serwera lub CDN. O tym, jak sygnały infrastrukturalne łączą się z widocznością w AI, piszemy w tekście ChatGPT Search i sygnały Cloudflare.
Podsumowanie
Odcinek Google'a niczego nie zmienia w standardzie, ale porządkuje oczekiwania. Robots.txt reguluje wejście, nie wykorzystanie. Skuteczne są wyłącznie poprawnie zapisane reguły dla konkretnych tokenów, a Google-Extended pokazuje, że nawet duży operator używa tego pliku do sygnalizowania preferencji użycia. Następny odcinek serii ma dotyczyć kodu 404.
Newsletter · piątek 9:00
Tydzień w marketingu w jednym mailu
Najważniejsze teksty tygodnia zebrane w jednym mailu. Wypis jednym kliknięciem.
Źródła
- PPC Land: Google says robots.txt limits AI crawling, not what bots do with data (otwiera się w nowej karcie)
- Google Search Central: How Google Interprets the robots.txt Specification (otwiera się w nowej karcie)
- IETF / RFC Editor: RFC 9309: Robots Exclusion Protocol (otwiera się w nowej karcie)
- PPC Land: Explaining Google-Extended (otwiera się w nowej karcie)
Widzisz błąd? Napisz do redakcji. Sprostowania: jak zgłosić.